AI for Science 正在把科学探索推向前所未有的规模。但在电子与原子的微观世界,仅靠实验难以覆盖庞大的材料、分子与构型空间,高质量第一性原理计算因此成为获取可靠物理数据的重要途径。当 AI for Science 开始以更快的速度消耗科学数据,科学计算本身也正在成为决定科学智能扩展能力的重要基础设施。
密度泛函理论(Density Functional Theory,DFT)是材料与分子研究中广泛使用的第一性原理电子结构方法。其中,交换关联(Exchange-Correlation,XC)求值用于描述电子的交换与关联效应,既影响 DFT 的计算精度,也是大规模计算中的关键瓶颈之一。
清华大学智能产业研究院(AIR)AIoT 团队联合北京大学、微软研究院和中国科学院提出 MakoXC,通过将物理规律带来的不规则稀疏结构重组为规则矩阵运算,把快速增长的 AI 算力高效转化为电子结构计算能力。在 64 张 NVIDIA A100 GPU 上,MakoXC 支撑的完整 DFT 系统将 1,231 个原子泛素体系的能量计算推进到五分钟以内。相关论文已被高性能计算国际顶级会议 SC’26(CCF-A) 接收;在后续系统工程与产业化探索中,团队也获得了澎峰科技的支持。
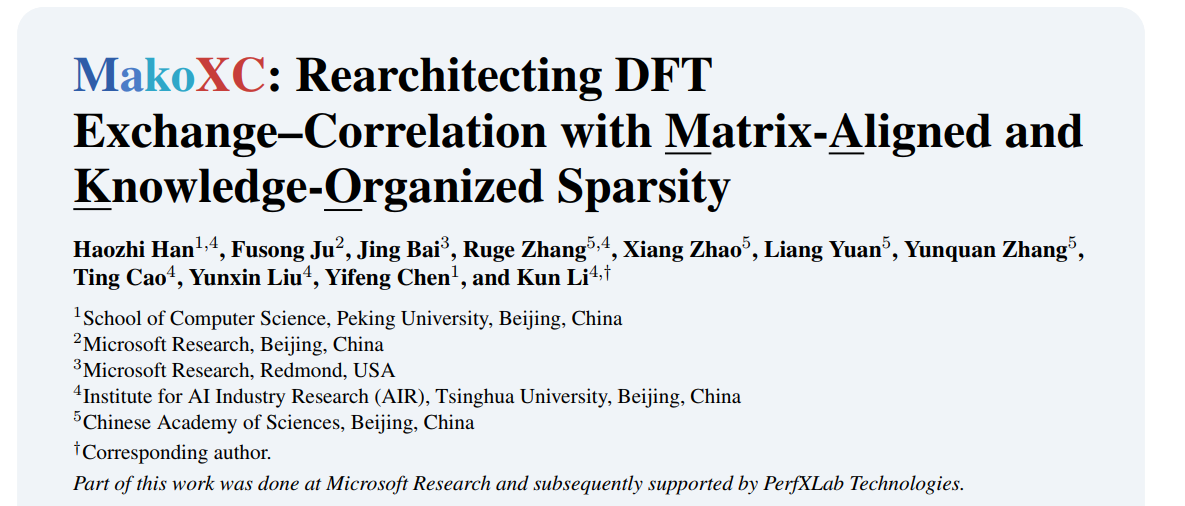
论文题目:MakoXC: Rearchitecting DFT Exchange-Correlation with Matrix-Aligned and Knowledge-Organized Sparsity
论文链接:https://arxiv.org/abs/2609.01025
论文作者:韩昊知,鞠富松,白静,张儒戈,赵翔,袁良,张云泉,曹婷,刘云新,陈一峯,李琨
材料是否稳定、分子在不同构型下具有怎样的能量,都与微观电子结构密切相关。这些物理信息也是材料与分子 AI 模型训练和验证的重要依据。
实验难以覆盖庞大的材料、分子和构型空间,因此,高精度计算模拟成为生成 AI for Science 数据的重要途径。DFT 可以从原子构型出发,计算体系的能量、受力等物理量,并为科学 AI 模型提供高质量训练数据。例如,Meta FAIR 2025 年发布的 Open Molecules 2025(OMol25)数据集,就包含超过 1 亿次高精度 DFT 计算,生成这些数据消耗了约 60 亿 CPU 核时。
当科学 AI 模型开始依赖如此大规模的第一性原理数据时,如何更快、更低成本地完成这些计算,也就成为扩展 AI for Science 数据基础的重要问题。
MakoXC 关注的,正是 DFT 中一个反复执行且直接影响DFT精度的重要计算瓶颈:交换关联(XC)求值。
02/电子近视性让计算变稀疏,却让 GPU 更难高效执行
XC 计算需要在大量空间网格点上构造电子密度、计算交换关联贡献,再将结果汇总回基函数空间。
传统稠密方法会在每个网格点处理大量基函数组合。随着体系增大,网格点和基函数数量同时增长,计算量近似呈立方增长。
好在,电子结构具有明显的空间局域性。在局域原子轨道表象下,远离原子中心后,基函数快速衰减,大量基函数的贡献可以直接忽略。这种电子近视性使 XC 计算能够只处理局部有效区域,从而显著降低算法复杂度。
但“少算”并不等于“更快”。
筛除无效贡献后,原本规则的稠密计算变成大量尺寸不同、分布不规则的小矩阵运算和细粒度 GPU kernel。而现代 GPU,尤其是AI加速器 Tensor Core,最擅长的却是规则、大粒度的矩阵计算。
于是形成了一个核心矛盾:电子近视性让算法“算得更少”,但现代 GPU 想要“算得更快”,需要的却是规则、高效的计算结构。
因此,如何把物理规律带来的稀疏性,真正转化为 GPU 上的计算效率,正是 MakoXC 要解决的问题。
03/核心思路:把物理稀疏性重组为 GPU 擅长的矩阵计算
MakoXC 抓住了电子近视性形成结构的一个关键特征:整体稀疏、不规则,但局部仍存在较为稠密的数据簇。
围绕这一特征,MakoXC 提出了三项关键技术。
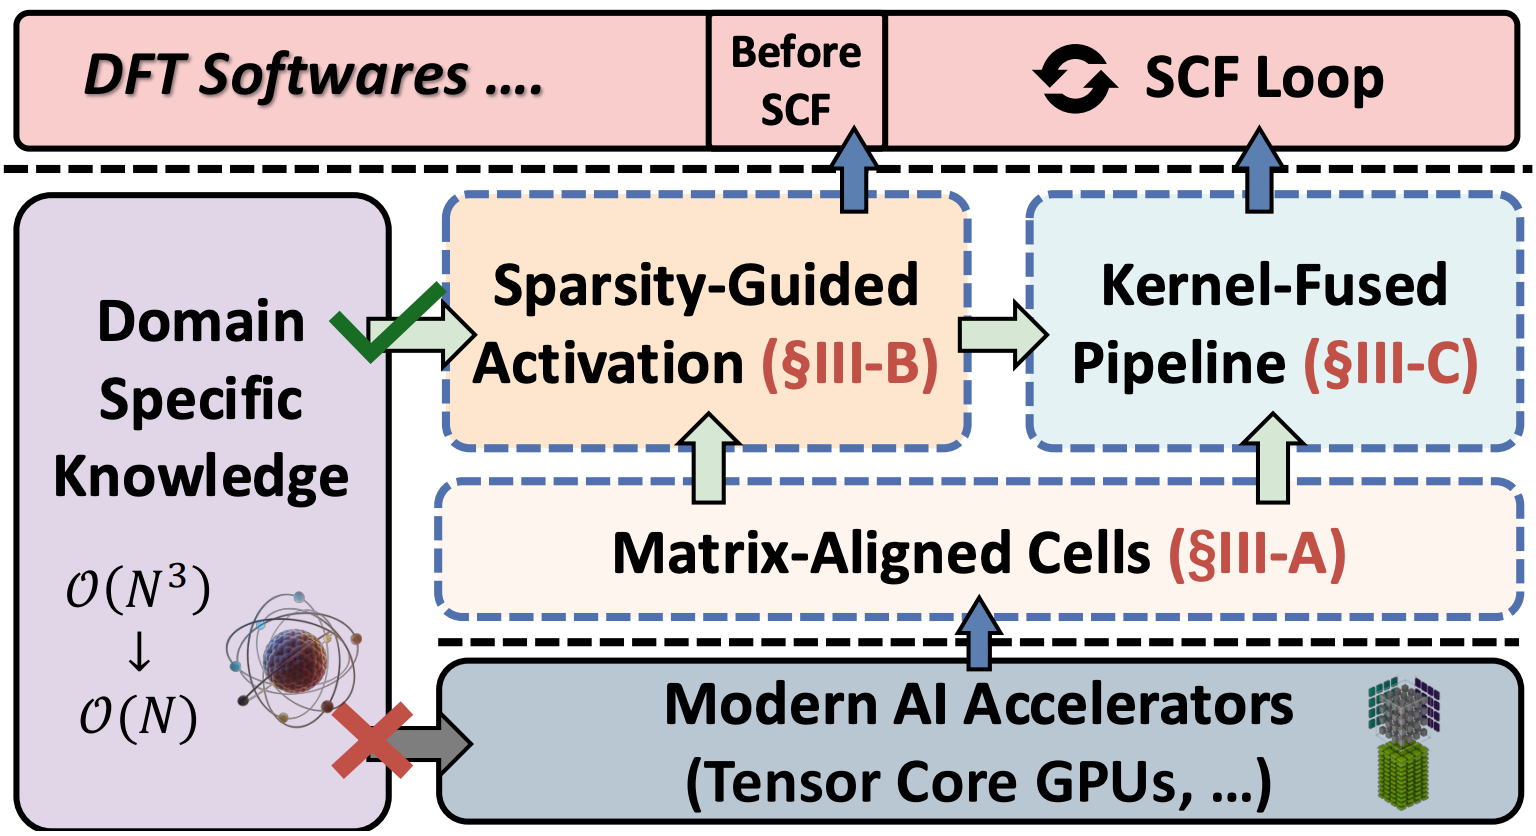
图一:MakoXC 的整体架构
第一,矩阵对齐单元(Matrix-Aligned Cells):把零散任务组织成规则矩阵块。
MakoXC 根据基组、积分网格和 GPU 片上存储容量划分矩阵对齐的计算块,使原本碎片化的任务形成适合 AI 加速器(矩阵运算单元)处理的规则结构。
第二,稀疏性引导激活(Sparsity-Guided Activation):把静态稀疏性编译成更少的访存和计算。
单个基函数有效,并不意味着任意两个基函数的组合都需要参与计算。MakoXC 进一步利用预先筛选的壳层对及其与密度矩阵的对应关系,识别真正有效的基函数组合。
关键在于,对于固定的原子构型、基组和积分网格,这种组合稀疏性是静态且可预先确定的。因此 MakoXC 可以在 SCF 迭代前将其编译为明确的稀疏数据访问与计算模式,并在后续迭代中反复复用,避免无效矩阵块的读取与计算,将静态稀疏性直接转化为更少的访存和运算。
第三,内核融合流水线(Kernel-Fused Pipeline):通过数学等价变换,把 XC 计算重构为片上连续执行的融合流水线。
MakoXC 并非简单拼接多个 GPU kernel,而是结合 OnlineDot 与 Symmetry Folding 的数学等价变换,重排矩阵乘法、点积和归约的执行顺序,使中间结果生成后即可被后续计算消费,并尽量保留在 GPU 片上存储中。
这一思路类似 FlashAttention:通过重排计算与数据流,避免中间张量反复写回、读回显存;同时利用密度矩阵的对称性,进一步消除重复的计算与访存。最终,MakoXC 将多个分离阶段压缩为精简的片上融合流水线,让 GPU 更专注于计算。
通过这三项设计,MakoXC 将物理规律中的稀疏结构转化为适合现代 GPU 的执行方式,让算法上的“少算”真正变成硬件上的“算得快”。
在多聚甘氨酸链、氮化硼片层和水团簇等体系,以及 def2-SVP、def2-TZVP 两种基组上的单张 NVIDIA A100 测试中,MakoXC 的 XC 模块相对稠密基线 DenseXC 平均加速 67.8 倍,相较于当前先进的线性复杂度方法平均加速 4.7 倍。同时,XC 计算耗时随体系规模增长呈接近线性的趋势,能量结果与参考软件保持良好一致性。
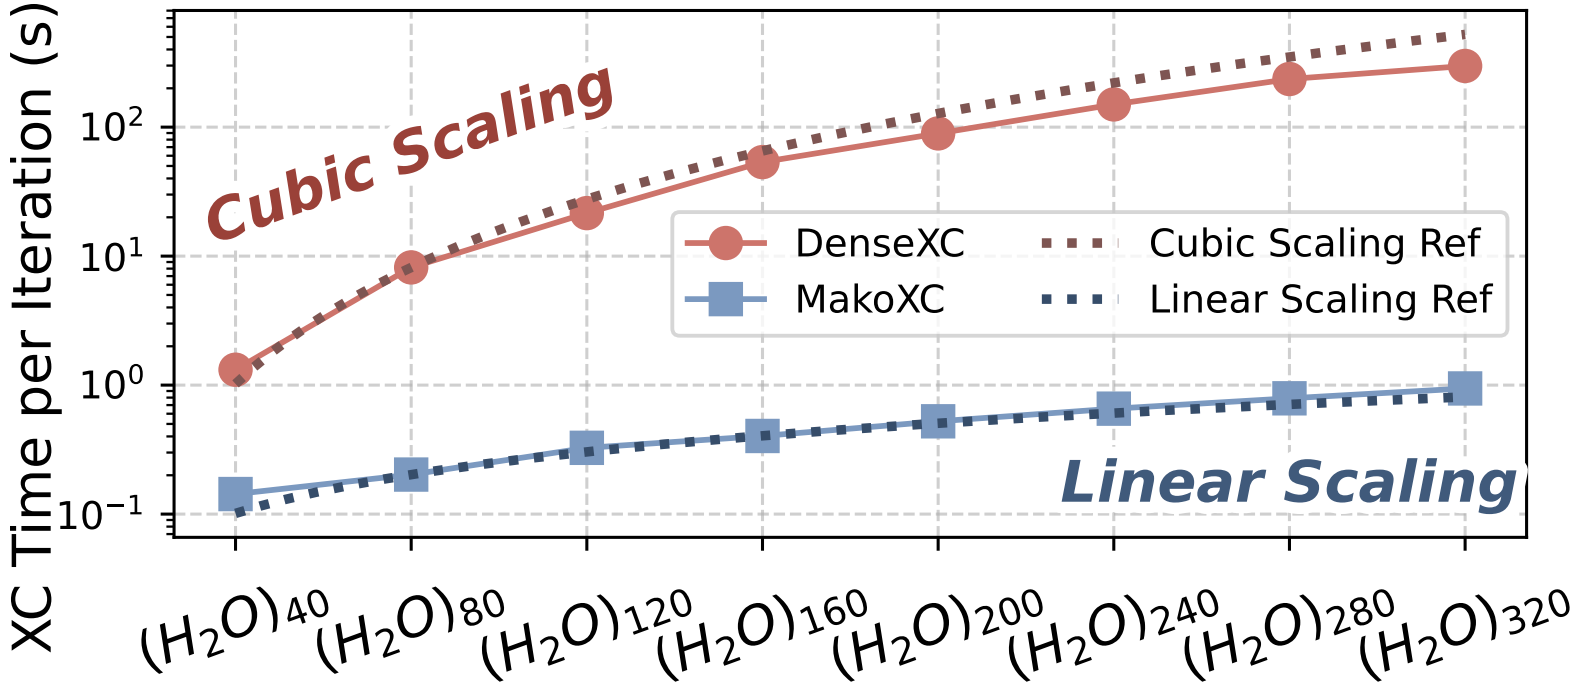
图二:MakoXC 的实际线性扩展性
进一步集成到完整 DFT 计算系统后,按平均 SCF 迭代耗时统计,系统在 def2-SVP 基组下相较于当前先进的 DFT 软件平均加速 3.94 倍。
在 64 张 A100 GPU 上,系统仍保持 74% 以上的并行效率,并在不足五分钟内完成包含 1,231 个原子的泛素体系的微观分子能量计算,实现从 XC 核心模块加速到千原子规模第一性原理计算的实际性能提升。
05/从科学计算到 AI for Science:让 AI 算力深入科学世界
从 Mako 到 MakoXC,研究团队持续探索同一个问题:如何把科学问题中的物理与数学结构,转化为现代 AI 加速器真正擅长的计算结构。
在 SC’25 的 Mako 工作中,团队已围绕第一性原理量子化学计算展开系统级重构;一年后的 MakoXC,则进一步深入由电子近视性产生的不规则稀疏计算,在降低算法复杂度的同时释放矩阵硬件效率。
从规则科学算子,到复杂电子结构计算,这些工作也逐渐汇聚成团队持续探索的 MatrixScience 研究方向。MatrixScience 系列工作也受到国际 HPC 社区关注,并获得PPoPP、SC等多个国际顶会最佳论文奖项与认可,NVIDIA 杰出工程师 Jeff Hammond 也曾公开表示,Mako 是他 2025 年的 “favorite paper”。
当第一性原理计算变得更快,研究人员便能在相同计算资源下探索更多材料、分子与构型,获得更大规模、更高质量的微观世界数据。对于越来越依赖计算数据的 AI for Science 而言,科学计算正在成为连接 AI 算力与真实物理世界的重要基础设施。
让物理规律降低计算复杂度,让矩阵化执行释放 GPU 算力——从 Mako 到 MakoXC,MatrixScience所尝试的,是把 AI 时代快速增长的计算能力,进一步转化为探索科学世界的能力。
参考链接:
The Open Molecules 2025 (OMol25) Dataset, Evaluations, and Models: https://arxiv.org/abs/2505.08762
Mako: https://dl.acm.org/doi/10.1145/3712285.3759829
MakoXC: https://arxiv.org/abs/2609.01025
PPoPP24 Best Paper Award: https://ppopp24.sigplan.org/program/program-PPoPP-2024/Detailed-Table?badge=Best%20Paper%20Award
SC25 Best Student Paper Finalist: https://sc25.conference-program.com/presentation/?id=pap417&sess=sess170
SC24 Best Reproducibility Advancement Finalist: https://dl.acm.org/doi/10.1109/SC41406.2024.00059
Mako 工作获 NVIDIA 杰出工程师 Jeff Hammond 的高度评价:https://lnkd.in/p/gjUNJQhm