具身智能的核心命题,正在从“模型能否完成动作”转向“系统能否在真实物理环境中稳定、持续地完成任务”。过去两年,VLA、世界模型等基础模型显著提升了机器人的初始操作能力;但当环境变化、执行误差和长尾情况出现时,仅靠离线数据训练得到的策略仍难以维持可靠性。物理世界中的摩擦、碰撞、位置变化和执行失败无法被离线数据穷举,这构成了具身智能从实验室走向真实场景的关键瓶颈。
围绕这一挑战,清华大学智能产业研究院(AIR)曹婷教授课题组将这一瓶颈作为核心科学问题,提出并系统定义了具身自进化:物理智能体在部署环境中持续交互,通过反馈与经验沉淀自主修正策略,并不断提升任务成功率。在此基础上,课题组形成了由模型、Agent与训推基础设施共同支撑的完整研究体系:Zeva实现上下文因果学习,Zetta ζ构建在线执行纠错闭环,Z-Infra提供端云全周期训推支撑。
目前,课题组已将该方向的核心成果以开源项目与技术报告形式开放:Zeva 提出上下文因果学习;Zetta ζ 实现在线执行纠错闭环。本文基于上述技术报告与开源实现,梳理课题组在具身自进化方向的研究进展。
Zeva 技术报告(arXiv:2608.30880):https://arxiv.org/abs/2608.30880
-
Zetta ζ 技术报告(arXiv:2608.16590):https://arxiv.org/abs/2608.16590
-
Zeva 项目主页:https://air-embodied-brain.github.io/Zeva/
-
Zetta 项目主页:https://air-embodied-brain.github.io/zetta/
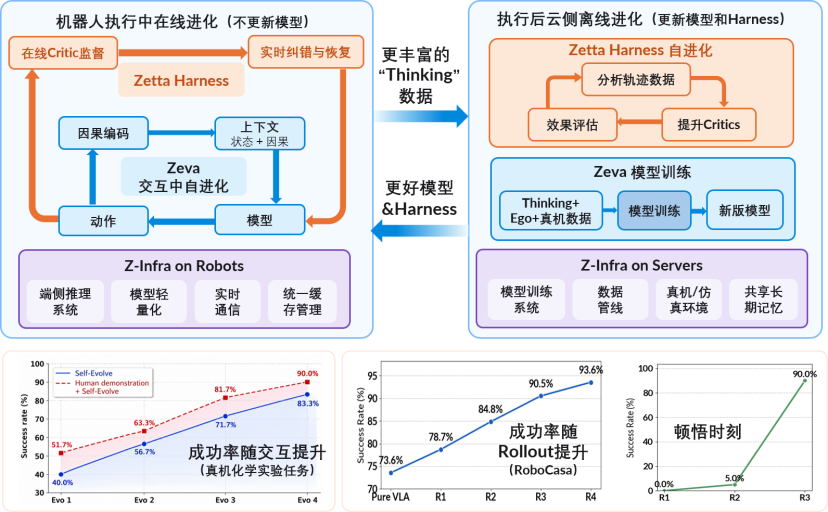
曹婷教授课题组具身自进化系统:Zeva与Zetta实现在线和离线模型及Harness学习闭环,Z-Infra以端云协同支撑全周期进化
01/从“能做”到“可靠做成”:具身智能的关键瓶颈
大模型的成功建立在“更多数据、更大参数、更多算力带来能力持续涌现”的逻辑之上。具身智能早期也延续了这条路径:采集更多操作数据,训练更大的VLA和WAM模型,再通过微调适配不同任务。这条路径能够显著提高机器人的初始能力,但它主要优化的是对数据中动作的复现,而真实环境最终要求的是任务稳定成功。
离线数据无法穷举持续变化的物理世界。机器人面对的摩擦、碰撞、位置变化和执行失败,只会在行动中真实发生;每换一个环境都重新采集、微调和部署,不仅难以规模化,也无法形成持续积累的能力。因此,从“能做”到“可靠做成”,关键不在于再进行一次离线训练,而在于让机器人能够在部署过程中利用真实反馈持续纠偏,把每次成功和失败转化为下一次行动的经验。
“自进化”在数字世界并非新概念,软件Agent、博弈智能和大模型领域已有多年探索。曹教授课题组率先将其拓展到真实物理世界,明确提出并定义具身自进化范式:物理智能体在部署环境中持续交互,通过反馈与经验沉淀自主修正策略,并不断提升任务成功率。课题组关注的不是机器人偶然成功一两次,而是它能否随着交互持续变强。因此,在课题组的几乎每项工作中,都能看到一条随交互次数增长的成功率Scaling曲线。
02/Zeva:上下文因果学习,让机器人“不更新参数也能变强”
Zeva是课题组开源发布的上下文因果学习模型。其核心目标是不更新模型参数,也能从机器人的每一次交互中学习真实物理条件,并将学到的经验用于后续动作。
近期,Generalist G1.5、Skild S1等工作推动了具身领域上下文学习的发展,让机器人能够利用上下文中的示范与经验适应新任务。但现有方法主要依赖人类示范。Zeva创新性提出上下文因果学习(In-Context Causal Learning,ICCL):让机器人从自身交互轨迹中提取动作与状态变化之间的因果关系,同时过滤背景、光照等无关相关性。机器人不是简单模仿别人做过什么,而是在当前物理条件下理解自己的动作为什么成功或失败,并将其应用到下一次改进。
Zeva的核心机制分为三个阶段。
第一阶段是因果交互提取。 Causal Transition Encoder(CTE)将视觉状态、执行动作和观察到的效果组合为“因果交互状态”,并进一步编码为任务阶段与交互信号。系统不仅记录“夹爪移动了一段距离”,更试图识别:机器人处在任务哪一步,动作使物体发生了什么变化,这种变化是否推动任务向目标前进。
第二阶段是双时标因果记忆。 Brief Interaction Trace(BIT)保留近期尝试中的动态信息,帮助机器人理解刚刚发生了什么;Persistent Interaction Memory(PIM)则在同一episode的多次尝试之间,按照相似度合并和巩固有用证据。前者类似工作记忆,后者更接近可持续积累的经验。机器人既不会被一次偶然失败带偏,也不会在开始新尝试后把此前线索全部清空。
第三阶段是上下文策略注入。 系统从记忆中检索与当前任务阶段相匹配的交互证据,为冻结的基础策略构造Causal Prompt。模型参数没有改变,但每一次决策所依据的上下文已经不同。过去的交互被压缩为可供下一次推理调用的因果经验。
这条路线最反直觉之处正在于此:模型不更新,能力却可以持续增长。 它把推理上下文变成学习的通道,也把机器人真实发生的失败从“无效样本”变为可利用的学习信号。根据Zeva技术报告,冻结模型在多个典型具身基准任务上的累计成功率从26%提升到73%;在RoboCasa365-Atomic5和真实化学实验室ChemLab-Evo评估中,均优于其他前沿VLA/WAM模型,取得SOTA。人类演示也可以进入同一套上下文,进一步提升约10%的成功率。这意味着,教会机器人一项新操作,有望从漫长的数据采集和训练工程,转变为更接近人类带教的过程:示范一次,让它尝试,在执行中纠偏,再把经验留下。
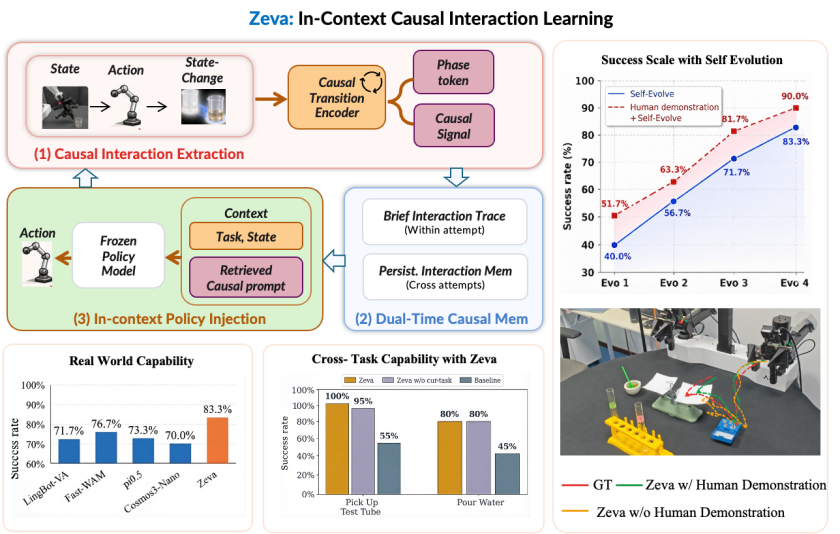
Zeva系统图和成功率随交互次数Scaling曲线
03/Zetta ζ:在线执行纠错闭环,让机器人边执行边进化
Zetta ζ是课题组开源发布的闭环在线学习Agent。它要解决的不是“会不会学”,而是“能不能在长程任务中稳定做成”。
Zeva让模型能够从交互中学习,但会学习不等于能把任务稳定做完。真实任务是一条长链路:机器人需要理解目标、拆解步骤、执行动作、观察结果,并在偏差出现时及时恢复。如果第一步没有抓稳杯子,后续“把杯子放进水槽”的计划再正确也没有意义。
近期Claude Plays Robotics、Aspire、Cap-X等工作开始探索用大模型监督具身任务,Agentic AI也将“规划—执行—反思”引入机器人领域。但真实世界不会停下来等待推理:每一步都调用大模型,几秒延迟就可能改变环境状态;只在任务结束后复盘,又来不及挽救已经偏离的执行过程。
Zetta ζ瞄准这一缺口,以具身Harness连接基础模型、机器人本体和环境反馈,首次提出可演进的轻量critic,通过三重闭环让在线闭环学习成为可能。
第一重是动作级纠错闭环。运行时critic持续监测机器人的物理状态,一旦发现抓取滑落、接触丢失或运输停滞,便立即触发恢复;只有故障解除、状态重新稳定,控制权才交还模型继续执行。机器人不必等到整个任务失败,才能知道哪一步出了问题。
第二重是批量经验优化闭环。完成一批rollout后,Zetta ζ会聚类失败轨迹,定位最早偏离正常状态的时刻,再从评估、状态表征、规划控制到恢复策略逐层诊断根因,并自动生成critic、recovery与tool的候选更新。
第三重是验证门控更新闭环。候选技能不会直接进入技能记忆库,而要先通过历史回归测试和隔离数据验证。只有真正提升成功率、并能泛化到新场景的更新,才会被保留,避免机器人只是“背下”某个失败样本。
三重循环让每次rollout不再是用完即弃的执行记录,而能沉淀为经过验证、可以复用的技能。根据Zetta ζ技术报告,在有限rollout budget下,Zetta ζ在LIBERO PRO和RoboCasa分别取得90.8%和93.6%的任务成功率,优于现有其他方法,且成功率随rollout持续增长。更值得关注的是,增长并不总是均匀发生:机器人可能连续多次失败,却在一次关键探索后掌握恢复策略,随后稳定成功。课题组将这种学习曲线上的能力跃迁称为机器人的“Aha Moment”。
如果说Zeva解决的是“如何从交互中学到因果经验”,Zetta ζ解决的则是“如何在长程执行中监督、纠错,并把经验沉淀为技能”。Model与Agent由此协同,让自进化不仅发生在一次推理中,也发生在机器人持续工作的过程中。
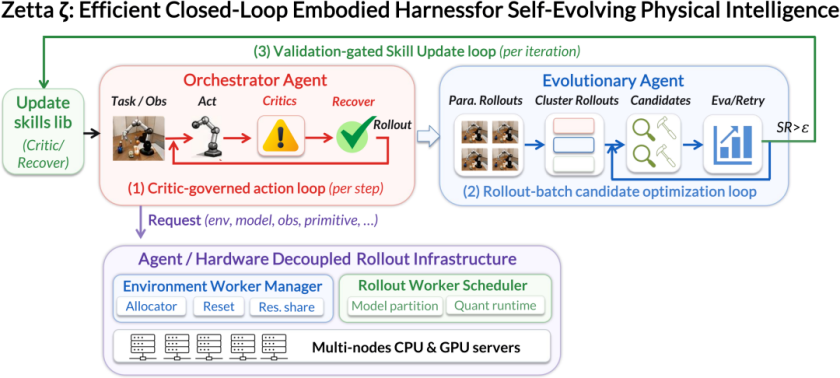
Zetta系统架构图
04/Z-Infra:支撑持续进化的端云训推基础设施
要让模型能力在真实系统中持续运行,仅有Zeva和Zetta ζ还不够,还需要一套支撑全周期进化的训练与推理基础设施。如果机器人在真实环境中产生的数据仍需人工拷贝、清洗、标注、训练和逐台更新,那么数据越多,系统迭代负担反而越大,难以形成闭环。真正的持续学习系统需要知道哪些数据有价值,能够高效完成rollout与评估,把经验注入模型或上下文,并快速部署到设备上验证。
Z-Infra覆盖机器人从部署到持续学习的全周期,包括数据管线、环境rollout管线以及高效部署推理管线。它一端连接真实场景中的机器人,另一端连接模型与Agent,使“交互—判断—记忆—调用—再交互”能够持续运转。由此形成三层完整架构:
Zeva Model负责把物理交互编码为因果经验,并在上下文中调用;
Zetta Harness负责在线执行、步骤监督、错误恢复和经验沉淀;
Z-Infra负责规模化数据流转、rollout和高效部署推理。
这套架构也解释了课题组为何强调端云结合的能力。机器人与物理世界的交互对延迟极为敏感,关键决策不可能永远等待云端返回。自进化若要成为机器人的基础能力,就必须在有限算力、功耗和存储条件下高效运行。曹婷教授过去在模型量化、查表计算与高效推理上的积累,在这里形成了一条连续的技术逻辑:过去是把更强模型装进有限硬件,现在是让持续学习与推理闭环也能进入机器人本体。T-MAC、BitDistiller、Pregated-MoE、LUT Tensor Core等系列工作,构成了课题组从算法到底层系统协同优化的技术基础。
需要指出的是,这是一条与纯预训练不同的Scaling路径:前者主要在训练之前扩大数据与参数,后者在部署之后扩大有效经验。两者并不冲突,但后者更有可能决定机器人能否从固定设置走向千差万别的真实场景。
05/技术领先性:完整、可验证、开放的具身自进化体系
作为开源项目,曹婷教授课题组的研究优势体现在技术体系的完整性与领先性,而非单一模型指标。
第一,问题定义与技术体系的完整性。课题组较早系统提出具身自进化,并围绕“模型—Agent—基础设施”形成闭环:Zeva负责从物理交互中学习因果经验,Zetta ζ负责执行监督、纠错与技能沉淀,Z-Infra负责全周期训推支撑。三者相互衔接,使自进化从概念走向可运行的完整技术栈。
第二,核心机制的原创性。Zeva提出ICCL与双时标因果记忆,让冻结模型在推理阶段持续吸收交互经验;Zetta ζ提出可演进轻量critic,并通过动作级纠错、批量经验优化和验证门控更新三重闭环,将失败转化为可复用技能。这些机制共同回答了“机器人如何在部署后继续学习”的关键问题。
第三,技术报告中的基准与真实场景验证。在上述技术报告的公开评测中,Zeva在RoboCasa365-Atomic5和ChemLab-Evo等评估中取得SOTA,冻结模型累计成功率从26%提升至73%;Zetta ζ在LIBERO PRO和RoboCasa上分别达到90.8%和93.6%,并表现出随rollout增长的成功率Scaling规律。课题组在多个典型任务中展示了“不更新参数也能持续变强”的能力。
第四,算法—系统—硬件协同的底层能力。课题组在边缘智能、模型量化、查表计算、高效推理和端云协同方面长期积累,使自进化闭环能够在真实硬件约束下运行。这种全栈协同能力,是支撑持续学习从论文走向真实系统的关键基础。
第五,开源开放带来的可验证性。Zeva与Zetta ζ均以开源项目和技术报告形式发布,公开了系统设计、核心机制与评测结果,便于社区复现和后续研究;Z-Infra则进一步提供面向持续进化的端云训推支撑。这种开放方式,使研究成果能够被更广泛地检验、复现和推进。
2026年6月6日,张宏江、张亚勤、Rahim Tafazolli、芮勇四位院士以及清华AIR院长刘洋等共同发布z0,首次系统呈现曹婷教授课题组的具身自进化技术路线。此后,Zetta ζ与Zeva相继开源,并公开技术报告。从z0到Zetta ζ再到Zeva,课题组在约三个月内连续补齐概念、Agent与模型框架,将该方向从名称推进为完整技术体系。
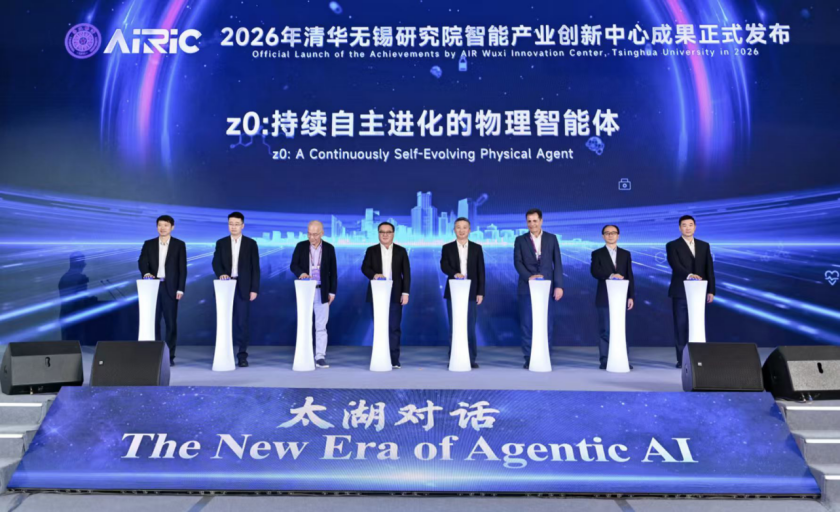
z0发布现场
06/研究展望:预训练之后,具身智能进入自进化阶段
过去两年,VLA、世界模型与大规模机器人数据完成了具身智能最重要的基础建设,让机器人从“不会做”走向“基本会做”。下一阶段的核心问题,不再只是把预训练模型做得更大,而是让机器人具备在真实环境中持续学习、持续纠错和持续积累经验的能力。
从Zeva的上下文因果学习,到Zetta ζ的在线执行与技能进化,再到Z-Infra对全周期进化的支撑,曹婷教授课题组已经跑通“交互产生数据—数据沉淀经验—经验提升能力—能力支撑更多交互”的研究闭环。这条路线也提出了新的开放问题:如何保证持续学习的安全性与可控性?如何设计更通用的因果表征与经验记忆?如何建立面向真实部署的评测基准与验证方法?如何让端侧系统在有限资源下支持长期进化?
具身智能的下一阶段,可能不会依赖某个单点模型的突然突破,而更像一条持续爬升的可靠性曲线。曹婷教授课题组和清华AIR正将研究重心放在这条曲线上:让机器人在真实物理世界中越用越强,让自进化成为具身智能的基础能力。