要想让机器人真正走进我们的日常生活,只会“动手”还不够。它还要记住做过什么、回答人的提问,在与人交流的同时持续完成手头的任务。然而,为了在机器人本地同时运行这些能力,必须要先突破端侧算力这个瓶颈:动作与语言推理会争抢计算资源,导致动作执行卡顿、或说话断断续续。如何让多种能力在有限算力下协同运行,已经成为具身智能从模型能力走向实际应用必须跨过的一道门槛。
针对这一瓶颈,清华大学智能产业研究院(AIR)联合清华大学电子工程系、中国科学技术大学提出OxyGen,通过统一KV Cache管理,为机器人同时处理动作与语言等多种任务提供高效的推理支持。相关论文已被人工智能领域顶会NeurIPS 2026接收。
OxyGen让动作与语言共享感知计算,并将语言生成拆分到多轮动作推理之间,把不同轮次的语言请求合并后批量处理。这既缩短了动作等待,又提高了语言处理效率,使原本争抢有限算力的多种任务,从“此消彼长”到“齐头并进”:同样的算力下,让机器人动作更流畅,处理对话、记忆等也更高效。
OxyGen已在openpi、StarVLA、Xiaomi-Robotics-0等主流具身推理框架与模型上完成验证并开源。在RTX 4090上的π₀.₅评测中,动作生成频率与语言总吞吐最高同时达到独立执行时的3.7倍。在人形机器人板载Jetson AGX Thor上,动作+语言推理总耗时从1030毫秒降至393毫秒,显著减少等待卡顿。
LIBERO动作与文本记忆实例。机器人在操作的同时记录“当前已经完成了什么”。同一任务中,OxyGen将回放总时长(包含模型推理与仿真动作执行)从25.1秒缩短至18.7秒。
上面的演示中,机器人一边抓取和放置物体,一边用文本记录已经完成的步骤,为后续任务提供记忆。在实际使用中,当有人询问进度时,它还需要根据当前场景作答。这些任务处理的是同一份观察信息,却要分别生成动作和文本,并在同一台设备上持续运行。
以π₀.₅为代表的基于Mixture-of-Transformers(MoT)架构的视觉语言动作模型(VLA),在架构层面支持了这样的多任务需求:共享的视觉语言骨干处理图像与指令,再由不同的专家生成动作和语言,使同一份输入可以服务于不同任务。但模型架构上的共享,并不会自动变成推理时的计算复用。如果系统仍然将动作与语言作为独立请求处理,同一份输入就会被重复计算。
在openpi等现有推理框架中,动作与语言请求分别处理图像和指令,将相同的计算结果保存在各自的KV Cache中,供后续生成使用。这就把有限的算力花在了重复计算上。即使共享了这部分结果,两类任务仍然会争抢计算资源:动作专家一次生成一段动作,语言专家则需要逐token生成文本。如果每轮都等待整段文本生成完毕,再开始下一轮动作推理,机器人就会为了写完一段记忆或讲完一段话,而耽误手头的动作。
但是,机器人一边操作一边记录,并不意味着每次更新动作前,都要先把这段记忆写完。动作需要及时接续,而文本记忆则可以跨几个控制周期逐步完成,这就给两类任务的调度留下了空间。要把语言生成穿插到连续的动作推理中,系统需要协调两种不同的缓存使用方式:动作专家在多步去噪中反复读取输入的前缀KV,语言专家则随着文本生成不断扩展自己的缓存。同时,每轮语言解码要控制在动作允许的等待时间内,尚未完成的请求还要保留生成进度,在后续轮次接着处理。为了支撑这样的协同执行,就需要将原本各自管理的KV Cache在任务之间共享,并随请求跨轮次保留。
03/统一KV Cache管理,让动作与语言一起提速
OxyGen通过统一KV Cache管理,把计算复用和任务调度结合起来。同一份观察只处理一次,得到的前缀KV由动作和语言共享;语言生成则拆分到多轮,并将不同轮次的请求组成batch批量处理。这两项优化分别对应跨任务KV共享和跨轮连续批处理。这里的关键在于,拆分至多轮后积累下来的语言请求,可以共同分摊模型权重读取等开销。每轮进行少量解码,就能同时推进多条请求,从而在缩短动作等待的同时,提高语言总吞吐。
具体执行时,每轮拿到新的观察后,OxyGen先做一次prefill,生成供动作专家和新建语言请求共同使用的前缀KV。动作输出后,新请求与此前尚未完成的请求一起进行限定步数的批量解码。已经生成完整文本的请求退出,其余请求保留各自的KV Cache和已生成token,留到下一轮继续处理。这样,来自不同轮次的请求既能一起计算,又各自保有完整的上下文;语言生成可以随着一次次动作更新持续推进,直到完成。每轮解码的步数决定了语言任务占用多少推理时间,也为不同场景下动作频率与语言响应的需求提供了调整空间。
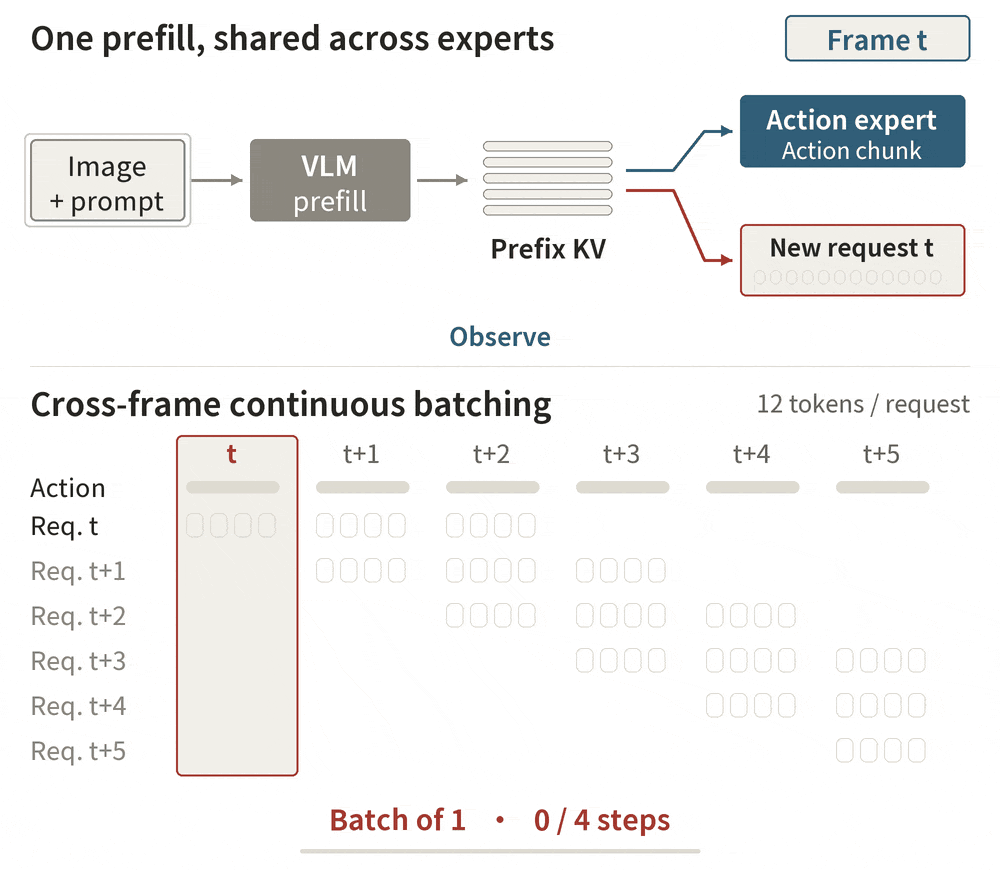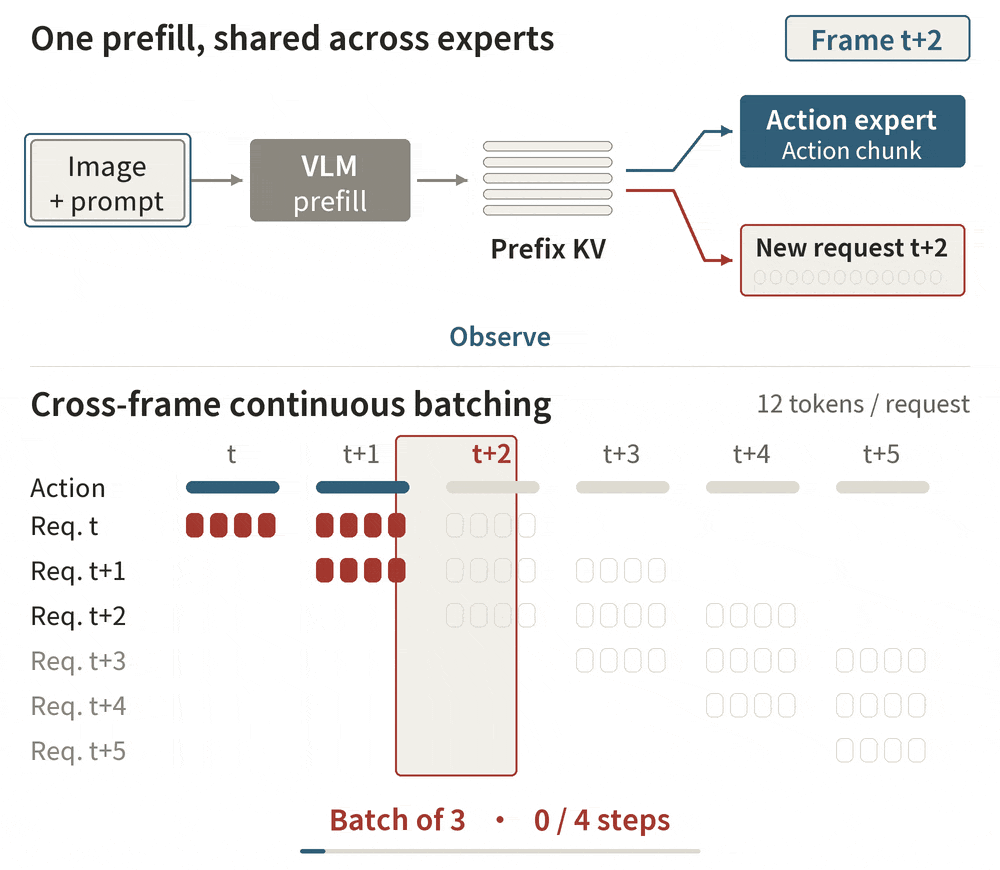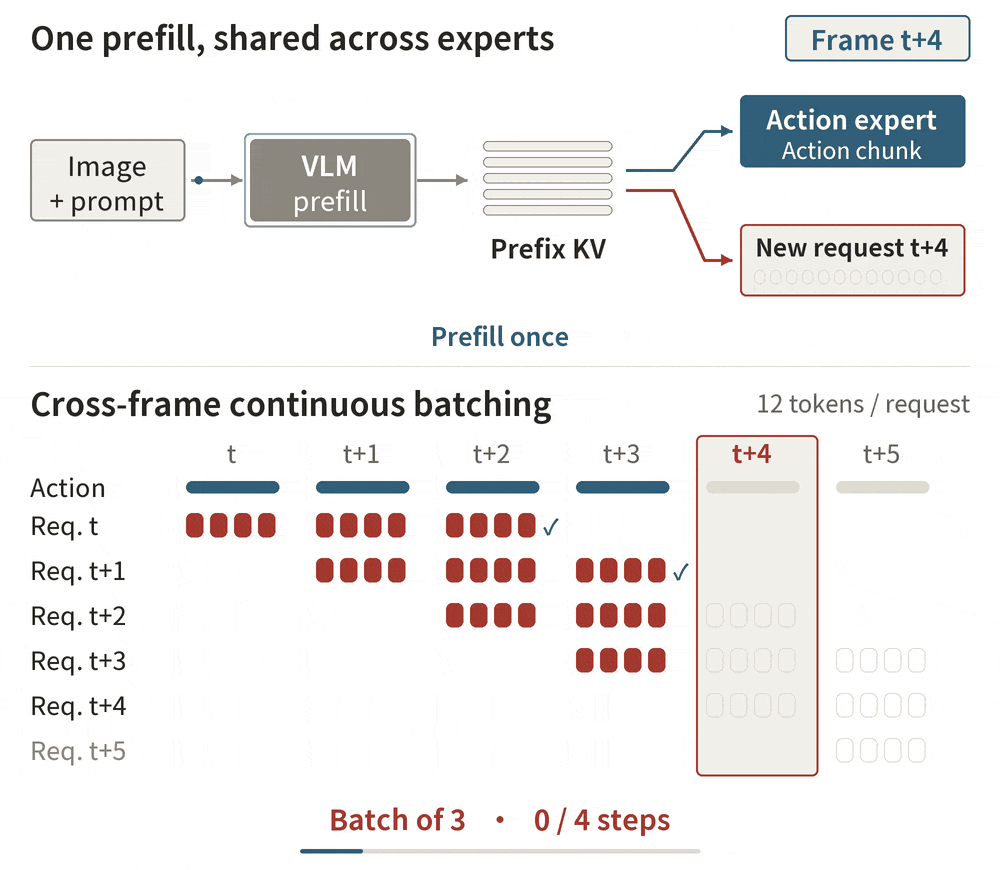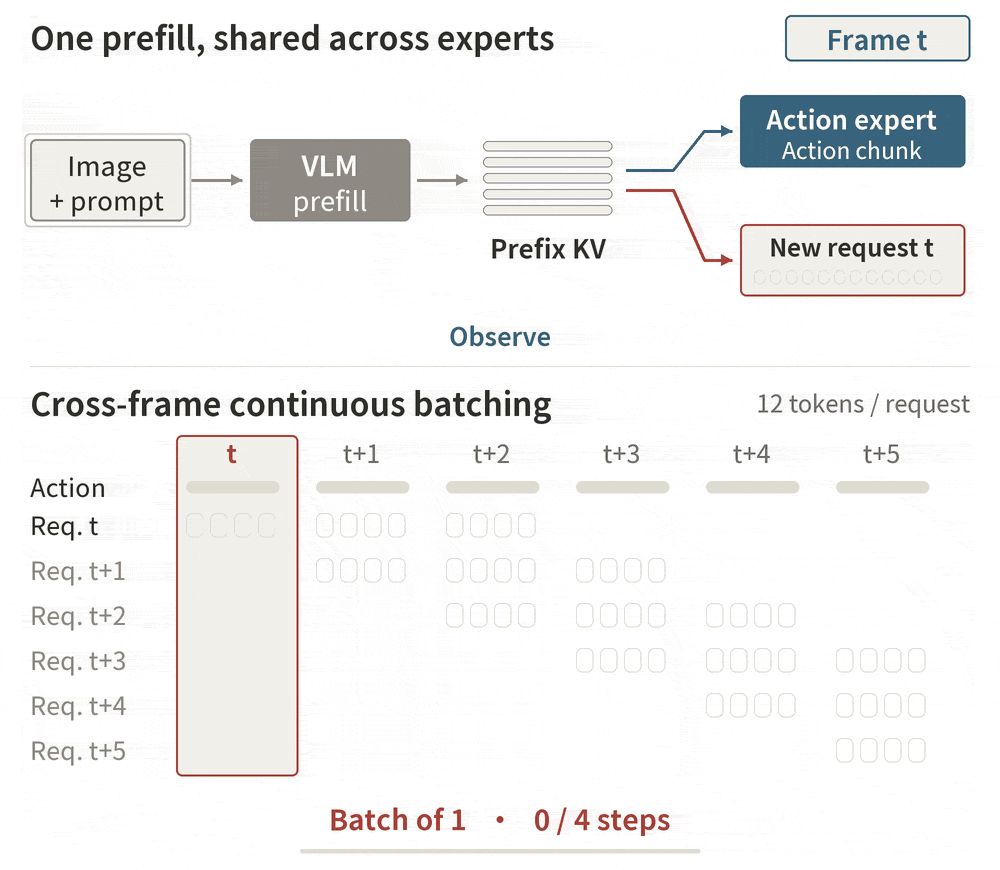
OxyGen统一KV Cache管理。上方展示共享前缀的生成与复用,下方为动作输出和跨轮次的语言解码。以每轮新增一条请求、每条生成12个token、每轮解码4步为例,稳定运行后,三个请求共同参与4步批量解码,每轮合计输出12个token;单条请求分三轮完成。相比每轮单独执行12步解码,批处理缩短了动作等待,提高了语言总吞吐。
团队首先在RTX 4090和Jetson AGX Thor上,采用LIBERO、DROID、ALOHA三类输入与控制配置,对π₀.₅进行了评测。在每条语言请求输出长度相同的情况下,OxyGen的动作生成频率与语言总吞吐最高同时达到顺序独立执行时的3.7倍。其中,在RTX 4090的LIBERO配置下,动作生成频率超过70 Hz,语言吞吐同时超过200 tokens/s,让机器人在更快生成动作的同时,处理更多的语言任务。
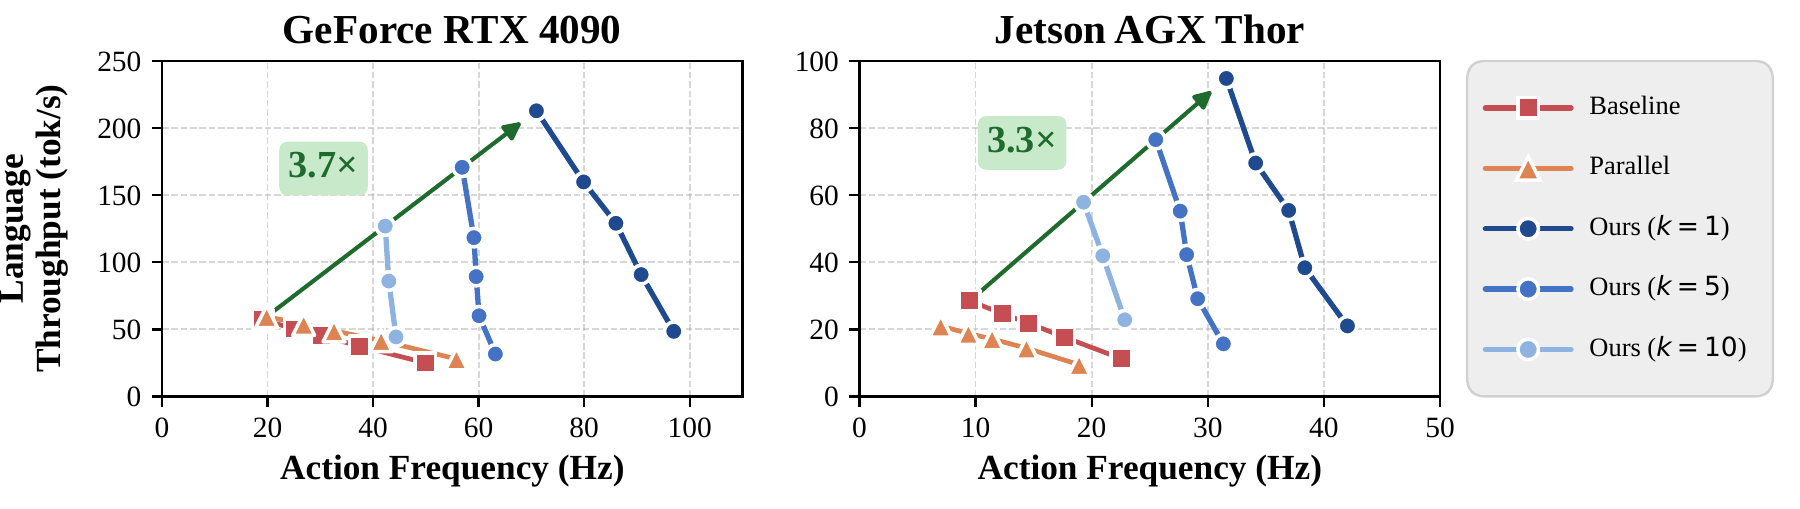
π₀.₅在LIBERO配置下的动作生成频率与语言吞吐。动作频率按每轮生成的动作数除以推理时间计算;本实验每轮生成10个动作。
在人形机器人板载Jetson AGX Thor上,OxyGen将动作与语言推理的总耗时从1030毫秒降至393毫秒。更直接的变化是,动作下发后的语言解码只需约195毫秒,可以在333毫秒的动作执行期间完成。机器人执行手头动作的这段时间,足以让语言推理继续推进,从而减少动作之间等待推理的停顿。
团队还将OxyGen应用到Xiaomi-Robotics-0和StarVLA的Qwen3VL-PI_v3上,验证这一方法在不同模型上的效果。在RTX 4090上,每条语言请求生成30个token、每轮解码1步时,两种模型的每轮推理分别获得5.83倍和6.64倍加速。进一步在StarVLA中增加动作专家后,共享前缀带来的收益也随之增加,说明这一设计可以支持更多专家共同使用同一份感知结果。
OxyGen已开源JAX与PyTorch实现,以及相应的模型适配和评测代码。研究者可以复现实验结果,也可以将这套推理方式用于采用共享骨干、需要同时生成动作与语言的具身模型,探索有限算力下的多任务协同。论文、代码与项目主页入口见文首链接。
围绕具身智能的实际部署,团队还开展了Zetta、Embodied.cpp等工作。Zetta关注机器人执行过程中的闭环自进化,让机器人及时发现执行偏差、采取恢复措施,并从失败经验中改进后续执行;Embodied.cpp面向异构硬件上的具身模型推理,让模型更容易部署到不同设备并高效运行。OxyGen则聚焦多种能力同时运行时的算力瓶颈,通过共享计算与协同调度,让机器人在有限资源下更好地“边说边做”。
相关推送链接
Zetta:机器人也有“Aha Moment”!Zetta ζ 闭环物理智能体在线学习
Embodied.cpp:Embodied.cpp:具身模型不再「慢半拍」
团队招聘信息
AIR AIoT团队常年招聘优秀博士后和实习生,研究方向包括物理智能基础模型和大模型训推系统等,欢迎发送简历至 tingcao@mail.tsinghua.edu.cn。团队介绍与详细招聘信息请见推送:https://mp.weixin.qq.com/s/fHG7GlCcwcActqMYMTGpwA。